Code
# rode isso apenas se voce estiver no colab!
# git clone https://github.com/ftl-brazil-2026/ebook.git
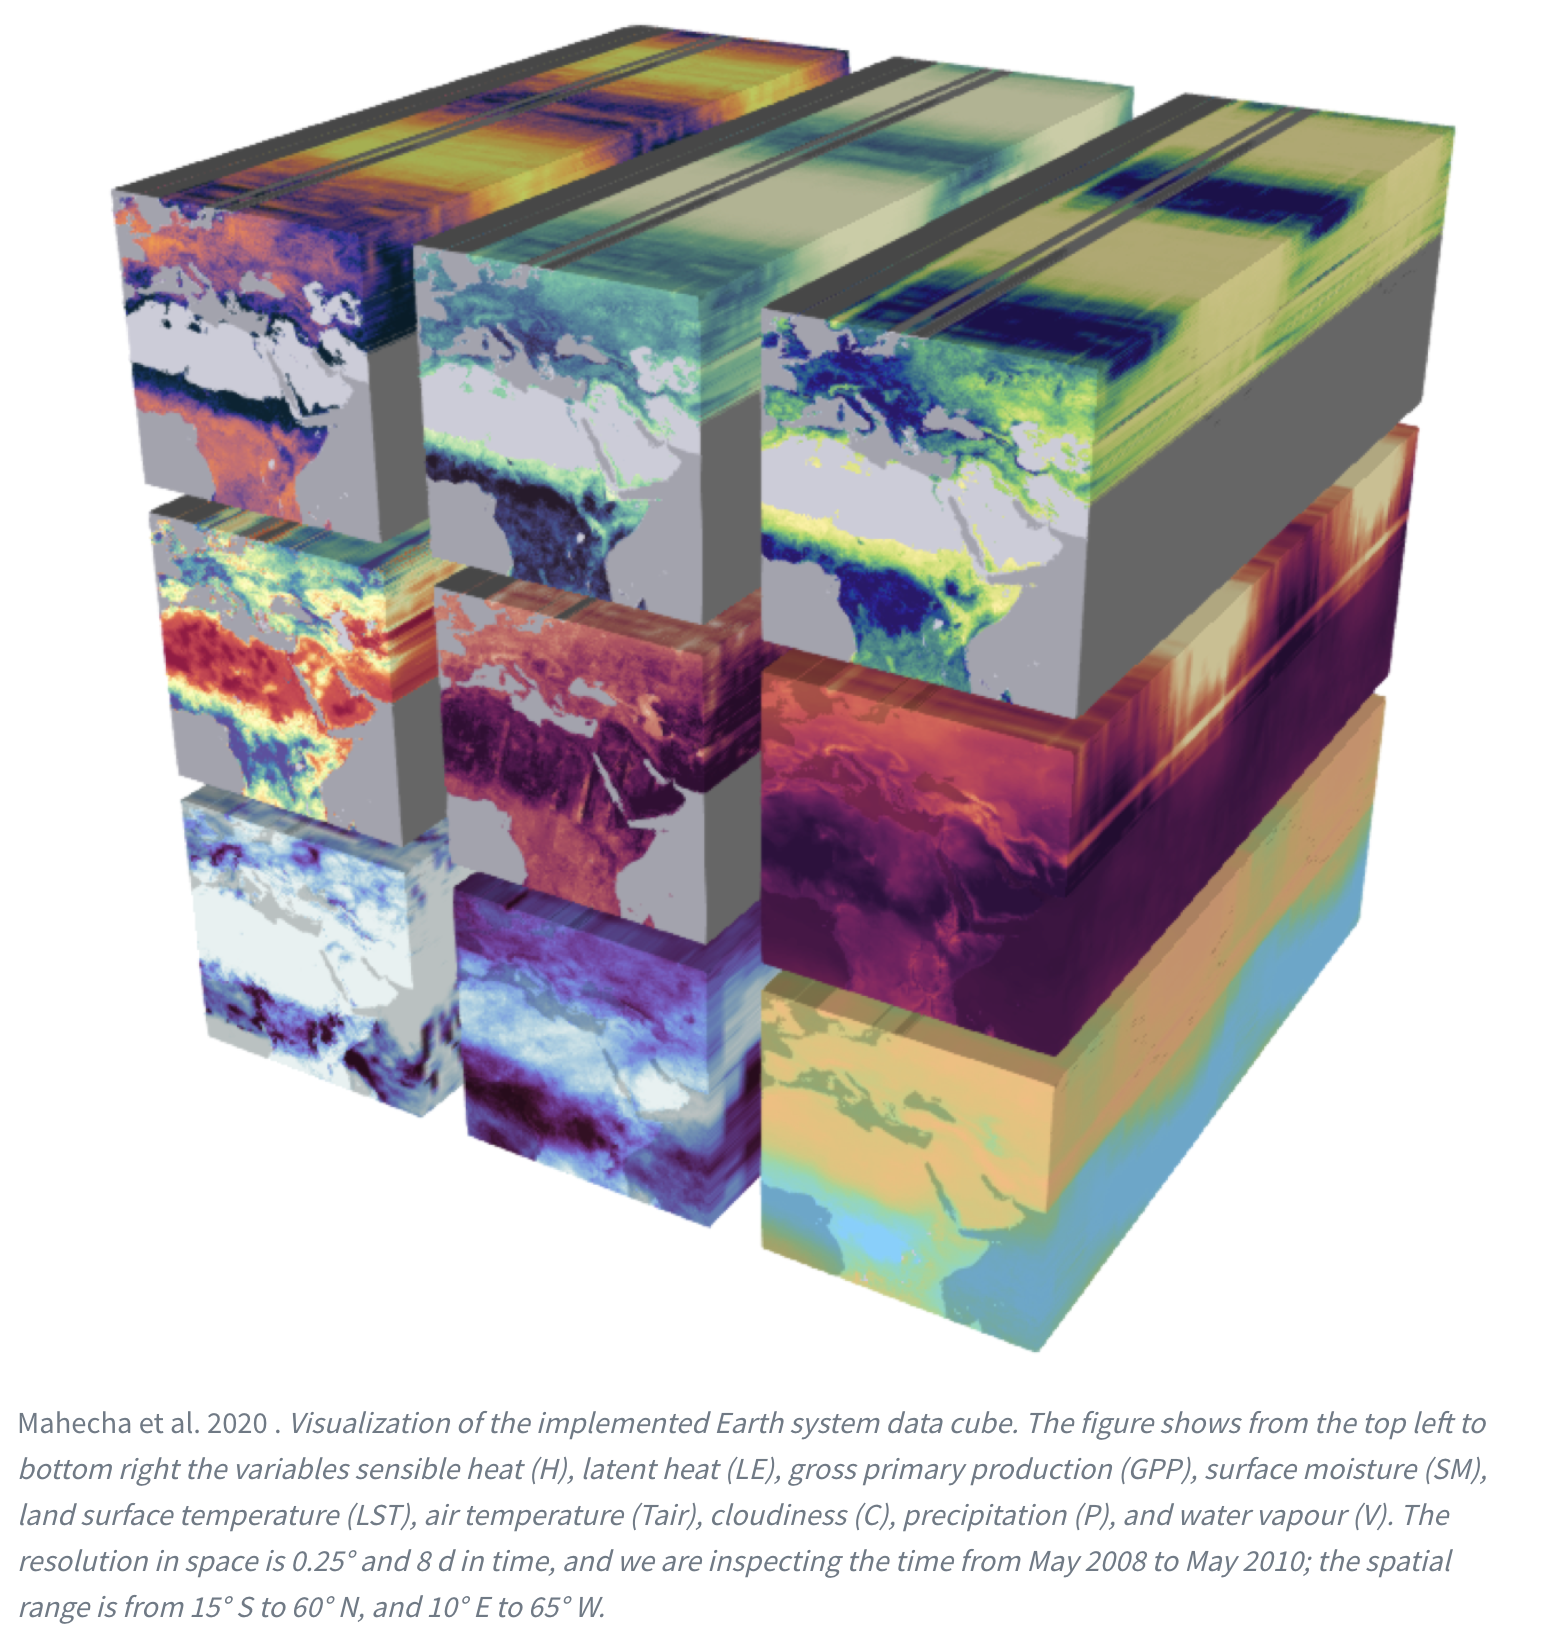
# pip install -r requirements.txtAté agora trabalhamos com vetores e rasters. Esses dados até agora eram normalmente bidimensionais ou tridimensionais, as vezes imagens espectrais contendo mais de uma banda. Contudo, quando falamos em Cubo de Dados boa parte dos dados de sensoriamento remoto e, principalmente, de reanálises climáticas (ERA5, CMIP, previsão numérica do tempo) tem várias dimensões ao mesmo tempo: tempo, latitude, longitude e às vezes nível vertical (altitude/pressão).
O xarray estende o numpy e o pandas para esse mundo N-dimensional, permitindo a agregação das coordenadas espaciais para um série temporal; pesquisa no eixo do tempo e coordenação entre multivariáveis.
Link Colab

# rode isso apenas se voce estiver no colab!
# git clone https://github.com/ftl-brazil-2026/ebook.git
# pip install -r requirements.txtimport os
import numpy as np
import pandas as pd
import xarray as xr
import rioxarray
import matplotlib.pyplot as plt
import seaborn as sns
import hvplot.xarray ## acessor of hvplot within xarray
import holoviews as hv
from dotenv import load_dotenv
load_dotenv()
sns.set_theme(style="whitegrid")dados[3, 12, 40] não diz nada sobre o que é o eixo 0, 1 ou 2.DataArray e DatasetDataArray: um array N-D + dims (nomes dos eixos) + coords (os valores de cada eixo: datas, latitudes…) + attrs (metadados livres: unidade, nome longo, etc).Dataset: um dicionário de DataArrays que compartilham as mesmas coordenadas — por exemplo, temperatura e precipitação vivendo no mesmo grid de tempo/lat/lon.Vamos criar dados sintéticos (não é ERA5 ainda) só para explorar a mecânica do xarray sem depender de rede.
rng = np.random.default_rng(42)

time = pd.date_range("2015-01-01", periods=24, freq="MS")
lat = np.linspace(-9.6, -9.2, 5)
lon = np.linspace(-40.7, -40.3, 5)

ciclo_sazonal = np.sin(2 * np.pi * (np.arange(24) / 12))[:, None, None]
temp_valores = 27 + 3 * ciclo_sazonal + rng.normal(0, 0.5, (24, 5, 5))

temp = xr.DataArray(
    temp_valores,
    dims=["time", "lat", "lon"],
    coords={"time": time, "lat": lat, "lon": lon},
    name="t2m",
    attrs={"units": "degC", "long_name": "Temperatura do ar a 2m (sintético)"},
)
temp
<xarray.DataArray 't2m' (time: 24, lat: 5, lon: 5)> Size: 5kB
array([[[27.15235854, 26.48000795, 27.3752256 , 27.47028236,
         26.02448241],
        [26.34891025, 27.0639202 , 26.8418787 , 26.99159942,
         26.57347804],
        [27.43969899, 27.38889597, 27.03301535, 27.5636206 ,
         27.23375467],
        [26.57035377, 27.18437539, 26.5205587 , 27.43922515,
         26.97503704],
        [26.90756882, 26.65953523, 27.61127067, 26.92273526,
         26.78583609]],

       [[28.32393322, 28.76615459, 28.68272203, 28.70636631,
         28.7154105 ],
        [29.5708238 , 28.29679249, 28.24387864, 28.09311364,
         28.80798971],
        [29.06448615, 28.44302627, 28.07992176, 28.08775939,
         28.82529639],
        [28.87162709, 28.77157713, 28.16724515, 28.61608066,
         28.5583429 ],
        [28.6093443 , 28.93571439, 28.61179777, 28.83945678,
...
         24.3583767 ],
        [24.24838218, 24.02516   , 23.88579245, 23.77968789,
         23.95752513],
        [24.3665836 , 24.56907135, 24.42749482, 24.01915615,
         24.85201607],
        [24.77163012, 24.32209963, 24.07546572, 24.67613775,
         24.49591058],
        [23.67786016, 24.36793366, 24.53294169, 23.9520764 ,
         24.49684549]],

       [[24.77258876, 26.16809305, 26.12397499, 25.37374133,
         25.68172717],
        [24.29503902, 24.92182617, 25.35311054, 24.96393349,
         25.85719824],
        [26.49864827, 24.91169264, 25.0812683 , 25.61772418,
         26.30555807],
        [24.88881284, 25.62451806, 26.41064943, 24.67412043,
         24.8594654 ],
        [25.2881967 , 25.23970579, 25.90630064, 25.62082986,
         24.61251897]]])
Coordinates:
* time (time) datetime64[us] 192B 2015-01-01 2015-02-01 ... 2016-12-01
* lat (lat) float64 40B -9.6 -9.5 -9.4 -9.3 -9.2
* lon (lon) float64 40B -40.7 -40.6 -40.5 -40.4 -40.3
Attributes:
units: degC
long_name: Temperatura do ar a 2m (sintético)Repare no repr acima. Ele mostra as dimensões, o tamanho de cada uma, as coordenadas e os atributos. Sendo muito mais informativo que um array.shape puro.
print("dims:", temp.dims)
print("shape:", temp.shape)
print("atributos:", temp.attrs)
temp.coords
dims: ('time', 'lat', 'lon')
shape: (24, 5, 5)
atributos: {'units': 'degC', 'long_name': 'Temperatura do ar a 2m (sintético)'}Coordinates:
* time (time) datetime64[us] 192B 2015-01-01 2015-02-01 ... 2016-12-01
* lat (lat) float64 40B -9.6 -9.5 -9.4 -9.3 -9.2
* lon (lon) float64 40B -40.7 -40.6 -40.5 -40.4 -40.3Dataset. Como várias variáveis estão agrupadas.Se quisermos analisar um regime de dado bioma, como o semiárido Brasileiro, diante de uma perspectiva climática, podemos procurar por correlações entre as variáveis como temperatura e precipitação. Entender um pouco da regionalidade climática que caracteriza aquela região.
Para nosso primeiro contanto com o Xarray, vamos criar uma precipitação sintética (chuva concentrada em poucos meses) e juntar tudo em um Dataset.
(np.arange(24) - 8) / 12array([-0.66666667, -0.58333333, -0.5 , -0.41666667, -0.33333333,
-0.25 , -0.16666667, -0.08333333, 0. , 0.08333333,
0.16666667, 0.25 , 0.33333333, 0.41666667, 0.5 ,
0.58333333, 0.66666667, 0.75 , 0.83333333, 0.91666667,
1. , 1.08333333, 1.16666667, 1.25 ])# imitando uma estacao chuvosa
estacao_chuvosa = np.sin(2 * np.pi * ((np.arange(24) - 8) / 12))[:, None, None]
precip_valores = np.clip(50 + 120 * estacao_chuvosa + rng.normal(0, 15, (24, 5, 5)), 0, None)
# criando um dataset em xarray
precip = xr.DataArray(
precip_valores,
dims=["time", "lat", "lon"],
coords={"time": time, "lat": lat, "lon": lon},
name="tp",
attrs={"units": "mm", "long_name": "Precipitação mensal (sintético)"},
)
ds_sintetico = xr.Dataset({"t2m": temp, "tp": precip})
ds_sintetico<xarray.Dataset> Size: 10kB
Dimensions: (time: 24, lat: 5, lon: 5)
Coordinates:
  * time     (time) datetime64[us] 192B 2015-01-01 2015-02-01 ... 2016-12-01
  * lat      (lat) float64 40B -9.6 -9.5 -9.4 -9.3 -9.2
  * lon      (lon) float64 40B -40.7 -40.6 -40.5 -40.4 -40.3
Data variables:
t2m (time, lat, lon) float64 5kB 27.15 26.48 27.38 ... 25.62 24.61
tp (time, lat, lon) float64 5kB 161.7 145.3 173.0 ... 192.3 154.1ds_sintetico.t2m.values.shape(24, 5, 5)Daqui em diante, vamos usar um recorte pequeno e real do ERA5-Land (diário) sobre Petrolina (PE) e Juazeiro (BA). Como analisar a mesma dupla de cidades do nosso estudo de caso mais à frente. A ideia é combinar a mecânica do xarray em um dataset climático.
Para acessar o Earth Data Hub, registre-se em platform.destine.eu e gere um personal access token na seção Quota & API Keys. Guarde-o no seu .env como EARTH_HUB_API_KEY (a chave já está prevista no .env_copy deste repositório).
Atenção à cota: a conta gratuita tem um limite de requisições por mês. Nunca chame .load()/.compute() no dataset inteiro. Recorte com .sel() primeiro (uma cidade, uma pequena caixa delimitadora, um intervalo de datas) e só então materialize.
edh_token = os.environ.get("EARTH_HUB_API_KEY")
assert edh_token, "Defina EARTH_HUB_API_KEY no seu .env (veja earthdatahub.destine.eu)"

# Catálogo completo de datasets ERA5 disponíveis: https://earthdatahub.destine.eu/collections/era5/datasets
# Confira lá o slug exato do dataset que quer usar (hourly, daily, monthly-means...)
ERA5_LAND_DAILY = "era5-land-daily-utc-v1"

era5_url = f"https://edh:{edh_token}@data.earthdatahub.destine.eu/era5/{ERA5_LAND_DAILY}.zarr"# Lazy load
ds_era5 = xr.open_dataset(era5_url,
chunks={},
engine="zarr")
ds_era5<xarray.Dataset> Size: 8TB
Dimensions: (valid_time: 28002, latitude: 1472, longitude: 3600)
Coordinates:
* valid_time (valid_time) datetime64[ns] 224kB 1950-01-01 ... 2026-08-31
* latitude (latitude) float64 12kB 90.0 89.9 89.8 ... -56.9 -57.0 -57.1
* longitude (longitude) float64 29kB 0.0 0.1 0.2 0.3 ... 359.7 359.8 359.9
Data variables: (12/14)
d2m (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
e (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
pev (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
ro (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
sp (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
ssr (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
... ...
swvl1 (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
swvl2 (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
t2m (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
tp (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
u10 (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
v10 (valid_time, latitude, longitude) float32 594GB dask.array<chunksize=(75, 150, 300), meta=np.ndarray>
Attributes:
GRIB_edition: 1
GRIB_centre: ecmf
GRIB_centreDescription: European Centre for Medium-Range Weather Forecasts
GRIB_subCentre: 0
Conventions: CF-1.7
institution: European Centre for Medium-Range Weather Forecasts
history: 2026-08-19T08:44 GRIB to CDM+CF via cfgrib-0.9.1...Vamos checar os dois antes de recortar.
lon_name = "longitude" if "longitude" in ds_era5.coords else "lon"
lat_name = "latitude" if "latitude" in ds_era5.coords else "lat"

lon_min_raw = float(ds_era5[lon_name].min())
lon_max_raw = float(ds_era5[lon_name].max())
lat_descendente = float(ds_era5[lat_name][0]) > float(ds_era5[lat_name][-1])
usa_0_360 = lon_max_raw > 180

print(f"{lon_name}: [{lon_min_raw:.2f}, {lon_max_raw:.2f}]")
print(f"{lat_name}: descendente? {lat_descendente}")
longitude: [0.00, 359.90]
latitude: descendente? TruePetrolina (PE) & Juazeiro (BA)
Vamos usar uma pequena caixa delimitadora ao redor das duas cidades.
import geobr
petrolina = geobr.read_municipality(code_muni=2611101, year=2020).to_crs(epsg=4326)
juazeiro  = geobr.read_municipality(code_muni=2918407, year=2020).to_crs(epsg=4326)
estados = geobr.read_state(year=2020).to_crs(epsg=4326)union = petrolina.union(juazeiro).geometry.iloc[0]
minx, miny, maxx, maxy = union.boundsimport folium
from shapely.geometry import box
bbox= union.bounds
bounds_polygon = box(*bbox)
centro_lat = (bbox[1] + bbox[3]) / 2
centro_lon = (bbox[0] + bbox[2]) / 2
m = folium.Map(location=[centro_lat, centro_lon], zoom_start=10)
folium.GeoJson(
bounds_polygon.__geo_interface__,
name="Bounds",
style_function=lambda x: {
'fillColor': 'none',
'color': 'blue',
'weight': 3,
'fillOpacity': 0
}
).add_to(m)
mlat_min, lat_max = miny, maxy
lon_min, lon_max = minx, maxx
ANO_INICIO, ANO_FIM = "2015-01-01", "2025-12-31"
def ajusta_lon(lon):
return lon % 360 if float(ds_era5.longitude.max()) else lon
fatia_lat = slice(lat_max, lat_min) if lat_descendente else slice(lat_min, lat_max)
fatia_lon = slice(ajusta_lon(lon_min), ajusta_lon(lon_max))
# selecionando
# temperatura a 2m
# precipitacao total
variaveis = ["t2m", "tp"]recorte = ds_era5[variaveis].sel(
valid_time=slice(ANO_INICIO, ANO_FIM),
**{lat_name: fatia_lat, lon_name: fatia_lon},
)
recorte<xarray.Dataset> Size: 5MB
Dimensions: (valid_time: 4018, latitude: 13, longitude: 11)
Coordinates:
* valid_time (valid_time) datetime64[ns] 32kB 2015-01-01 ... 2025-12-31
* latitude (latitude) float64 104B -8.7 -8.8 -8.9 -9.0 ... -9.7 -9.8 -9.9
* longitude (longitude) float64 88B 319.1 319.2 319.3 ... 319.9 320.0 320.1
Data variables:
t2m (valid_time, latitude, longitude) float32 2MB dask.array<chunksize=(34, 13, 11), meta=np.ndarray>
tp (valid_time, latitude, longitude) float32 2MB dask.array<chunksize=(34, 13, 11), meta=np.ndarray>
Attributes:
GRIB_edition: 1
GRIB_centre: ecmf
GRIB_centreDescription: European Centre for Medium-Range Weather Forecasts
GRIB_subCentre: 0
Conventions: CF-1.7
institution: European Centre for Medium-Range Weather Forecasts
history: 2026-08-19T08:44 GRIB to CDM+CF via cfgrib-0.9.1...Só agora, com o recorte pequeno definido, materializamos os dados de fato.
Se estiver muito grande/lento na sua conexão, reduza ANO_INICIO/ANO_FIM primeiro.
%%time
# talvez leve alguns minutos
recorte = recorte.load()
CPU times: user 6.58 s, sys: 1.17 s, total: 7.74 s
Wall time: 2min 18sO ERA5 guarda temperatura em Kelvin e precipitação acumulada em metros. Convertendo para °C e mm:
dados = xr.Dataset()

dados["t2m_celsius"] = recorte["t2m"] - 273.15
dados["t2m_celsius"].attrs = {"units": "degC", "long_name": "Temperatura do ar a 2m"}

dados["tp_mm"] = recorte["tp"] * 1000
dados["tp_mm"].attrs = {"units": "mm", "long_name": "Precipitação"}

dados
<xarray.Dataset> Size: 5MB
Dimensions: (latitude: 13, longitude: 11, valid_time: 4018)
Coordinates:
* latitude (latitude) float64 104B -8.7 -8.8 -8.9 -9.0 ... -9.7 -9.8 -9.9
* longitude (longitude) float64 88B 319.1 319.2 319.3 ... 319.9 320.0 320.1
* valid_time (valid_time) datetime64[ns] 32kB 2015-01-01 ... 2025-12-31
Data variables:
t2m_celsius (valid_time, latitude, longitude) float32 2MB 26.76 ... 29.69
tp_mm (valid_time, latitude, longitude) float32 2MB 0.1642 ... 0.0....isel vs .selAssim como o pandas e o geopandas possuem suas maneiras de indexar e selecionar alguams fatias, o xarraytambém possui suas manhas.
.isel() seleciona por posição (como array[0]), igual numpy..sel() seleciona por rótulo (uma data, uma coordenada), o jeito que você realmente pensa sobre os dados.method="nearest" acha o ponto de grade mais próximo de uma coordenada que não é exata. Esse método é essencial pois permite buscar um ponto dentro do grid que o xarray dataset está estabelecido.ajusta_lon(-40.502)319.498primeiro_dia = dados.isel(valid_time=0) # por posição
janeiro_2020 = dados.sel(valid_time="2020-01") # por rótulo
ponto_petrolina = dados.sel(
**{lat_name: -9.389,
lon_name:
ajusta_lon(-40.502)},
method="nearest"
) # célula mais próxima
ponto_petrolina["t2m_celsius"]<xarray.DataArray 't2m_celsius' (valid_time: 4018)> Size: 16kB
array([27.748444, 27.670319, 28.467194, ..., 31.600006, 32.006256,
       30.787506], shape=(4018,), dtype=float32)
Coordinates:
* valid_time (valid_time) datetime64[ns] 32kB 2015-01-01 ... 2025-12-31
latitude float64 8B -9.4
longitude float64 8B 319.5
Attributes:
units: degC
long_name: Temperatura do ar a 2mNo numpy puro, somar dois arrays exige que as formas “batam” na ordem certa. No xarray, o alinhamento é feito pelo nome das dimensões e pelos valores das coordenadas
temp_fahrenheit = dados["t2m_celsius"] * 9 / 5 + 32  # transformando em fahrenheit

# opa, aqui as coisas ficam interessante
# amplitude termica: diferença entre o dia mais quente e o mais frio do período, célula a célula
amplitude_termica = dados["t2m_celsius"].max("valid_time") - dados["t2m_celsius"].min("valid_time")
amplitude_termica
<xarray.DataArray 't2m_celsius' (latitude: 13, longitude: 11)> Size: 572B
array([[11.21875  , 11.2578125, 11.1953125, 11.1484375, 11.1328125,
        11.03125  , 10.9140625, 10.984375 , 10.875    , 10.875    ,
        10.75     ],
       [11.21875  , 11.2265625, 11.25     , 11.1328125, 11.09375  ,
        11.0703125, 10.9296875, 10.9453125, 10.890625 , 10.8984375,
        10.8515625],
       [11.2578125, 11.25     , 11.2265625, 11.1796875, 11.1015625,
        11.1015625, 11.03125  , 11.       , 10.9453125, 10.9609375,
        11.0234375],
       [11.28125  , 11.2890625, 11.28125  , 11.25     , 11.2265625,
        11.2265625, 11.1796875, 11.1015625, 10.9453125, 11.       ,
        10.9921875],
       [11.3359375, 11.3671875, 11.3203125, 11.34375  , 11.3515625,
        11.3671875, 11.3203125, 11.21875  , 11.0625   , 11.       ,
        11.046875 ],
       [11.2890625, 11.4140625, 11.46875  , 11.5234375, 11.5390625,
        11.5      , 11.4609375, 11.375    , 11.2421875, 11.1015625,
        11.125    ],
       [11.0625   , 11.515625 , 11.5625   , 11.6015625, 11.75     ,
        11.71875  , 11.625    , 11.59375  , 11.4765625, 11.390625 ,
        11.4375   ],
       [11.03125  , 11.3203125, 11.75     , 11.75     , 11.9765625,
        12.03125  , 12.0078125, 11.9140625, 11.7578125, 11.671875 ,
        11.78125  ],
       [11.5078125, 11.6953125, 11.7890625, 11.9609375, 12.125    ,
        12.1171875, 12.15625  , 12.125    , 11.9921875, 11.8984375,
        11.9921875],
       [11.53125  , 11.703125 , 11.984375 , 12.078125 , 12.265625 ,
        12.2109375, 12.3125   , 12.296875 , 12.140625 , 12.1484375,
        12.109375 ],
       [11.7890625, 11.9609375, 12.       , 12.15625  , 12.390625 ,
        12.3515625, 12.40625  , 12.359375 , 12.3125   , 12.2734375,
        12.171875 ],
       [11.9765625, 11.8828125, 11.9609375, 12.125    , 12.34375  ,
        12.375    , 12.3828125, 12.4375   , 12.5      , 12.40625  ,
        12.21875  ],
       [11.90625  , 11.9765625, 12.1015625, 12.0625   , 12.3203125,
        12.3984375, 12.53125  , 12.4921875, 12.4921875, 12.5234375,
        12.28125  ]], dtype=float32)
Coordinates:
* latitude (latitude) float64 104B -8.7 -8.8 -8.9 -9.0 ... -9.7 -9.8 -9.9
* longitude (longitude) float64 88B 319.1 319.2 319.3 ... 319.9 320.0 320.1
Attributes:
units: degC
long_name: Temperatura do ar a 2mReduzir ao longo de ["lat", "lon"] dá uma série temporal (1 valor por tempo).
Reduzir ao longo de "time" dá um mapa (1 valor por célula).
media_espacial = dados.mean(dim=[lat_name, lon_name])  # série temporal
media_temporal = dados.mean(dim="valid_time")           # mapa médio


media_espacial["t2m_celsius"].plot(marker="o", figsize=(10, 3))
plt.title("Temperatura média espacial ao longo do tempo — ERA5-Land (Petrolina/Juazeiro)")
plt.tight_layout()
plt.show()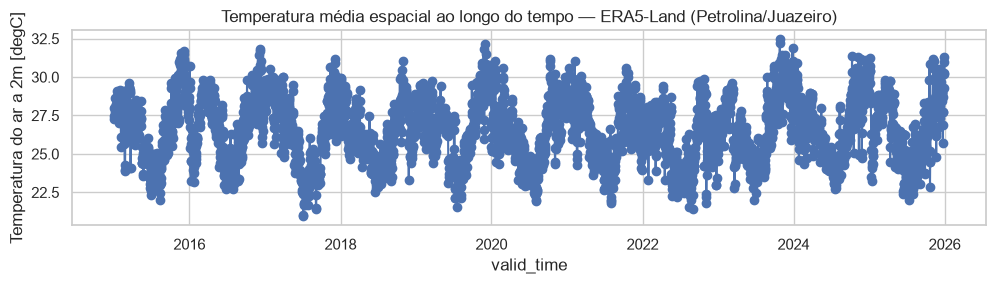
# exploremos
#dados['tp_mm'].groupby("valid_time.month").max().# dados["t2m_celsius"].groupby("valid_time.month").min().mean(dim=[lat_name,lon_name]).hvplot.line(
# x="month", marker="o",
# height=300,
# width=650,
# title="Minima Temperatura do Ar. Mensalmente para os anos de 2015-2025 ",
# xlabel="Mês",
# ylabel="Temperatura (°C)",
# )groupby e resample: climatologia e agregações temporaisgroupby("time.month") agrupa todos os janeiros juntos, todos os fevereiros juntos, por aí vai. Essa é a nossa base para calcular uma climatologia (ciclo sazonal médio).resample("YE") (ou "1D", "1MS"…) são diferentes formas de reagrupar essa dada frequência temporal em uma nova frequência que faça sentido para nossa análise.climatologia_fundamentos = dados.groupby("valid_time.month").mean()
climatologia_fundamentos["t2m_celsius"].mean(dim=[lat_name, lon_name]).hvplot.line(
x="month", marker="o", height=300, width=650,
title="Ciclo sazonal médio de temperatura — ERA5-Land (Petrolina/Juazeiro)",
xlabel="Mês", ylabel="Temperatura (°C)",
)chunksQuando possuimos dados que não cabem na memória (o que de fato é a maioria dos dados geoespacias e análise para um país de dimensão continental) é impossível carregar tudo isso na memória RAM do seu computador. Dessa forma, temos algumas maneiras bem inteligentes de lidar com esses dados. Uma dessas maneiras é utilizando chunks. Quando você abre um dataset com chunks={...} (ou chunks="auto"), o xarray usa Dask por baixo, assim as operações ficam preguiçosas (lazy) e nada é lido de fato até você chamar .load() ou .compute(). Essa mesma estratégia que existe no xarray é utilizada por exemplo no GEE. Isso permite selecionar (.sel) um recorte pequeno de um dataset gigante e só então materializá-lo.
“Zarr is like parquet for arrays”
Zarr is an open-source protocol for storing multi-dimensional-array datasets, like measurements over time, space, or other variables, as N-dimensional arrays. Think of it as a lightweight, modular alternative to older formats like HDF5, designed to work especially well with cloud storage and large-scale computing.
O NetCDF tradicional é um único arquivo binário, para ler um pedacinho, muitas vezes é preciso baixar o arquivo inteiro. O Zarr quebra o array em chunks (blocos) guardados como objetos separados, o que combina perfeitamente com armazenamento em nuvem (S3, Azure Blob) e acesso via HTTP. No fim, ele permite que você leia apenas os blocos que precisa. É por isso que provedores modernos de reanálise, como o Earth Data Hub da DestinE, que distribuem o ERA5 em Zarr ao invés de NetCDF.
dados.rio.write_crs("EPSG:4326", inplace=True)
print("CRS:", dados.rio.crs)
CRS: EPSG:4326beleza, já vimos o básico do xarray com dado de verdade. Bora aprofundar a análise no estudo de caso completo.
Petrolina e Juazeiro são cidades-irmãs separadas pelo rio São Francisco, no coração do semiárido nordestino. O clima é quente e com chuvas escassas e concentradas e, ainda assim, a região é um dos maiores polos de fruticultura irrigada de exportação do Brasil (manga, uva), graças à irrigação a partir do rio São Francisco. Essa tensão entre clima semiárido e agricultura irrigada é um ótimo motivo para olhar com cuidado para os dados climáticos da região.
Vamos usar o ERA5-Land (reanálise da ECMWF, ~9 km de resolução), acessado via Earth Data Hub (EDH) da plataforma DestinE, um espelho do ERA5 em Zarr na nuvem, que permite abrir o dataset inteiro de forma preguiçosa (lazy) e baixar só o recorte espaço-temporal de que precisamos.
Dado o espelho de zarr que escolhemos do Earth Data Hub, os dados estão já agregados por dia. Podemos tanto fazer os plots a nível de dia ou podemos rearranjar eles para plotar a nível de mês.
dados_diarios = xr.Dataset()
dados_diarios["t2m_celsius"] = dados["t2m_celsius"]
dados_diarios["tp_mm"] = dados["tp_mm"]

dados_mensais = xr.Dataset()
dados_mensais["t2m_celsius"] = dados_diarios["t2m_celsius"].resample(valid_time="1MS").mean()
dados_mensais["tp_mm"] = dados_diarios["tp_mm"].resample(valid_time="1MS").sum()

dados_mensais
<xarray.Dataset> Size: 152kB
Dimensions: (latitude: 13, longitude: 11, valid_time: 132)
Coordinates:
* latitude (latitude) float64 104B -8.7 -8.8 -8.9 -9.0 ... -9.7 -9.8 -9.9
* longitude (longitude) float64 88B 319.1 319.2 319.3 ... 319.9 320.0 320.1
* valid_time (valid_time) datetime64[ns] 1kB 2015-01-01 ... 2025-12-01
spatial_ref int64 8B 0
Data variables:
t2m_celsius (valid_time, latitude, longitude) float32 76kB 27.98 ... 27.87
tp_mm (valid_time, latitude, longitude) float32 76kB 14.81 ... 7.867Ciclo médio mensal, tirando a média espacial sobre a bbox. Como podemos entender o semiárido brasileiro?
# aqui reduzimos o espaço(x,y) para uma dimensão temporal
media_espacial_mensal = dados_mensais.mean(dim=[lat_name, lon_name])

# já aqui agregamos todos os meses, mes a mes, para calcular a média de cada mes
# dessa forma, cada pixel contem a media no eixo temporal, entre 2015-2023
grupo = media_espacial_mensal["t2m_celsius"].groupby("valid_time.month")
clim_media = grupo.mean()
clim_max   = grupo.max()
clim_min   = grupo.min()

climatologia = media_espacial_mensal.groupby("valid_time.month").mean()

temp_plot = climatologia["t2m_celsius"].hvplot.line(
    x="month", color="firebrick", height=300, width=420,
    title="Temperatura média mensal", xlabel="Mês", ylabel="°C",
)
precip_plot = climatologia["tp_mm"].hvplot.bar(
    x="month", color="steelblue", height=300, width=420,
    title="Precipitação média mensal", xlabel="Mês", ylabel="mm",
)

opts = dict(x="month",
            height=300,
            width=420)

temp_plot = (
    clim_max.hvplot.line(**opts, color="darkred", line_dash="dashed", label="Máxima")
    * clim_media.hvplot.line(**opts, color="firebrick", line_width=2.5, label="Média")
    * clim_min.hvplot.line(**opts, color="darkorange", line_dash="dashed", label="Mínima")
).opts(title="Temperatura mensal", xlabel="Mês", ylabel="°C", legend_position="bottom_right")

precip_plot = climatologia["tp_mm"].hvplot.bar(
    x="month", color="steelblue", height=300, width=420,
    title="Precipitação média mensal", xlabel="Mês", ylabel="mm",
)


temp_plot + precip_plotUma anomalia é o desvio de cada mês em relação à sua climatologia (o normal esperado para aquele mês). Anomalias negativas de chuva persistentes indicam períodos de seca.
climatologia<xarray.Dataset> Size: 288B
Dimensions: (month: 12)
Coordinates:
* month (month) int64 96B 1 2 3 4 5 6 7 8 9 10 11 12
spatial_ref (month) int64 96B 0 0 0 0 0 0 0 0 0 0 0 0
Data variables:
t2m_celsius (month) float32 48B 27.56 27.4 27.56 ... 27.91 28.25 28.28
tp_mm (month) float32 48B 68.14 57.23 63.67 ... 10.54 33.26 32.66anomalia = media_espacial_mensal.groupby("valid_time.month") - climatologia
linha_zero = hv.HLine(0).opts(color="black", line_width=0.8)
(
anomalia["tp_mm"].hvplot.line(
x="valid_time", color="steelblue", height=300, width=850,
title="Anomalia mensal de precipitação — Petrolina/Juazeiro",
xlabel="Data", ylabel="Anomalia (mm)",
)
* linha_zero
)t2m_media_simples = dados_mensais["t2m_celsius"].max(dim="valid_time")
# mesma conversão 0-360 - -180/180 de sempre
t2m_media_simples = t2m_media_simples.assign_coords(
**{lon_name: (((t2m_media_simples[lon_name] + 180) % 360) - 180)}
).sortby(lon_name)
t2m_media_simples.hvplot.image(
x=lon_name, y=lat_name, cmap="YlOrRd", colorbar=True,
title="Temperatura minima (2015-2025) Petrolina & Juazeiro",
height=420, width=460,
)import matplotlib.pyplot as plt
import cartopy.crs as ccrs
proj = ccrs.PlateCarree()
t2m_media = dados_mensais["t2m_celsius"].mean(dim="valid_time")
# a grade do ERA5-Land aqui ainda está na convenção 0-360° (ex: 319.9),
# como vimos lá em "Convenções do ERA5". Convertendo para -180/180 antes
t2m_media = t2m_media.assign_coords(
**{lon_name: (((t2m_media[lon_name] + 180) % 360) - 180)}
).sortby(lon_name)
lon_vals = t2m_media[lon_name].values
lat_vals = t2m_media[lat_name].values
p = t2m_media.plot(
subplot_kws=dict(projection=proj,
facecolor="lightgray"),
transform=proj,
cmap="YlOrRd",
cbar_kwargs={"label": "Temperatura média 2015-2025 (°C)"},
figsize=(7, 6),
)
ax = p.axes
for cidade, cor, nome in [(petrolina, "black", "Petrolina"), (juazeiro, "black", "Juazeiro")]:
ax.add_geometries(cidade.geometry, crs=proj, facecolor="none", edgecolor=cor, linewidth=1.5, label=nome)
# extent a partir da própria grade ERA5
margem = 0.1
ax.set_extent(
[lon_vals.min() - margem, lon_vals.max() + margem, lat_vals.min() - margem, lat_vals.max() + margem],
crs=proj,
)
ax.set_title("Petrolina e Juazeiro. Temperatura media entre 2015-2025")
plt.show()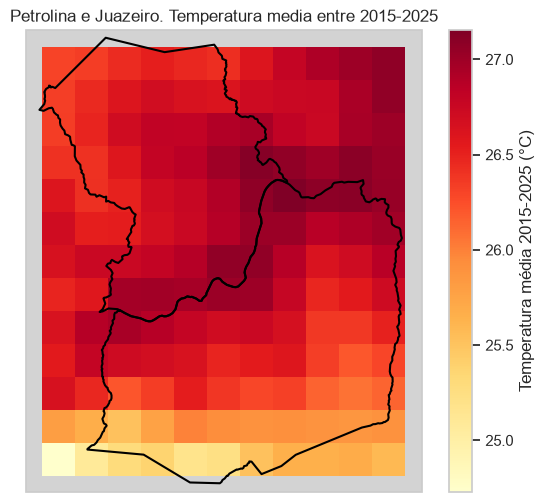
Podemos também criar um facet grid plot para reproduzir um painel de mapas, passando diferente valores por dimensão. Apenas passando col="month". Pra isso precisamos da climatologia por célula do grid, não a espacialmente-agregada que já calculamos lá em cima (aquela virou 1 valor por mês; essa aqui mantém latitude/longitude).
# climatologia mensal por célula do grid (mantém latitude/longitude, a media do mês)
climatologia_espacial = dados_mensais.groupby("valid_time.month").mean()

t2m_climatologia = climatologia_espacial["t2m_celsius"].assign_coords(
    **{lon_name: (((climatologia_espacial[lon_name] + 180) % 360) - 180)}
).sortby(lon_name)

fg = t2m_climatologia.plot(
    col="month",
    col_wrap=4,
    transform=proj,
    subplot_kws={"projection": proj},
    cmap="YlOrRd",
    cbar_kwargs={"orientation": "horizontal",
                 "shrink": 0.8,
                 "aspect": 40,
                 "label": "Temperatura média (°C)"},
    robust=True,
)

for ax in fg.axs.flat:
    for cidade, cor in [(petrolina, "black"), (juazeiro, "navy")]:
        ax.add_geometries(cidade.geometry, crs=proj, facecolor="none", edgecolor=cor, linewidth=1)
    ax.set_extent(
        [t2m_climatologia[lon_name].min() - 0.1, t2m_climatologia[lon_name].max() + 0.1,
         t2m_climatologia[lat_name].min() - 0.1, t2m_climatologia[lat_name].max() + 0.1],
        crs=proj,
    )

plt.show()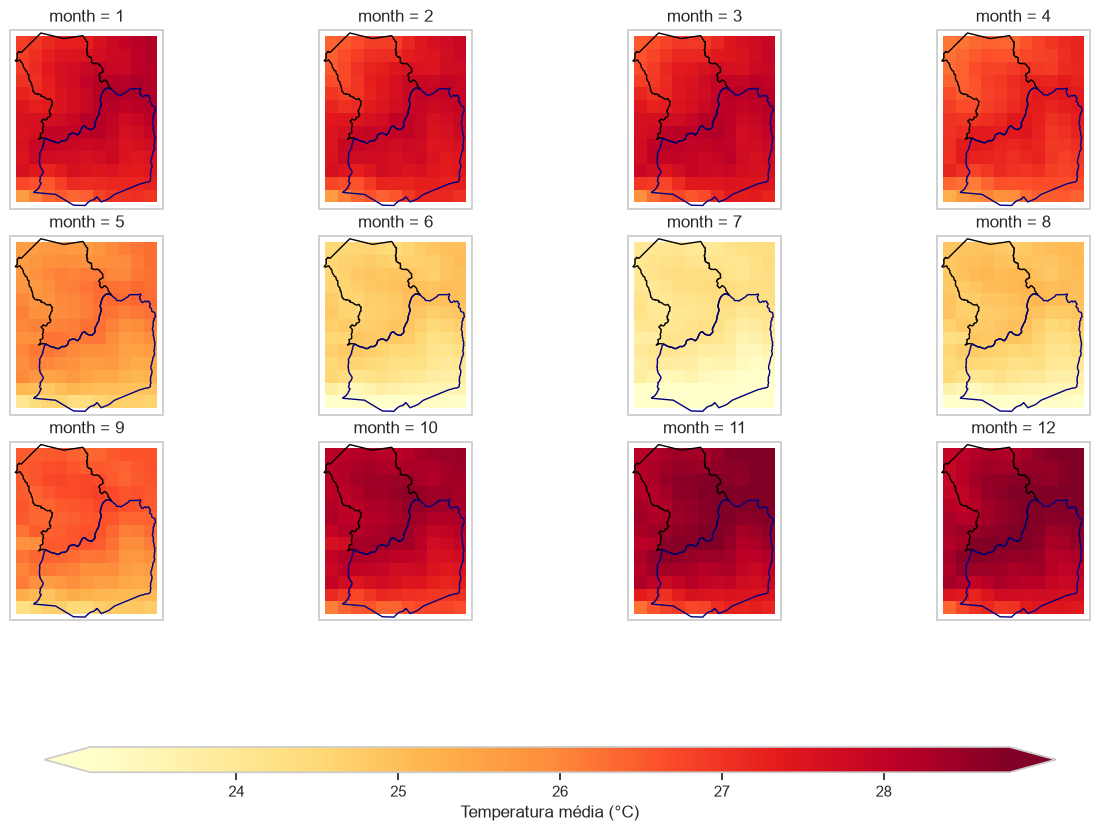
Aqui, utilizarei apenas 1 ponto ao inves de pegar uma malha para poder analisar uma série temporal maior sem depender de acessar uma parcela muito grande de dados. Minha idéia por aqui é entender como as mudanças climáticas estão impactando nas temperaturas minimas extremas. Isso é, quando uma noite fica acima de 25C, é considerado como extreme-heat wave, onda extrema de calor. Isso porque uma noite de 25C é excessivamente quente.
Entao para conseguir esse resultado, vou primeiro escolher uma cidade da regiao de goias, recalcular o dado do ERA5 para a minima diaria, se a minima diária excede 25 entao conto 1, e somo para o ano. Isso implicará em uma gráfica de barras com 25 anos contando quantas noites excederem 25C
edh_token = os.environ.get("EARTH_HUB_API_KEY")
assert edh_token, "Defina EARTH_HUB_API_KEY no seu .env (veja earthdatahub.destine.eu)"

# Catálogo completo de datasets ERA5 disponíveis: https://earthdatahub.destine.eu/collections/era5/datasets
# Diferente da seção anterior, aqui precisamos do dado HORÁRIO (não do diário já
# agregado), porque só com valores por hora dá pra calcular a mínima de cada dia.
ERA5_LAND_HOURLY = "era5-land-v0"

era5_url_horario = f"https://edh:{edh_token}@data.earthdatahub.destine.eu/era5/{ERA5_LAND_HOURLY}.zarr"Esse são os dados do espelho do ERA5 em horas. Aqui temos um volume de dados muito maior porque estamos discretizando por horas.
Vamos aproveitar pra checar as mesmas duas convenções (longitude e ordem da latitude) que vimos antes, já que cada dataset do EDH pode vir com uma convenção diferente.
ds_era5_horario = xr.open_dataset(era5_url_horario, chunks={}, engine="zarr")

lon_name_h = "longitude" if "longitude" in ds_era5_horario.coords else "lon"
lat_name_h = "latitude" if "latitude" in ds_era5_horario.coords else "lat"

usa_0_360_h = float(ds_era5_horario[lon_name_h].max()) > 180
lat_descendente_h = float(ds_era5_horario[lat_name_h][0]) > float(ds_era5_horario[lat_name_h][-1])

print(f"{lon_name_h}: usa 0-360? {usa_0_360_h}")
print(f"{lat_name_h}: descendente? {lat_descendente_h}")
longitude: usa 0-360? True
latitude: descendente? TrueEm vez de uma caixa delimitadora, aqui vamos pegar só um ponto, diferente do que já buscamos um slice do da area.
goiania = geobr.read_municipality(code_muni=5208707, year=2020).to_crs(epsg=4326)
centro_goiania = goiania.geometry.iloc[0].centroid
lat_goiania, lon_goiania = centro_goiania.y, centro_goiania.x

print(f"Goiânia (GO): lat={lat_goiania:.3f}, lon={lon_goiania:.3f}")
Goiânia (GO): lat=-16.643, lon=-49.274Como é um ponto só (não uma malha), mesmo pegando dado horário por décadas o volume final não é significativo, por isso dá pra usar uma janela bem mais longa do que na análise em grade lá em cima. Continua valendo a mesma regra: .sel() primeiro (ponto + intervalo de tempo), preguiçoso, e só depois .load().
def ajusta_lon_h(lon):
    return lon % 360 if usa_0_360_h else lon

ANO_INICIO_PONTO, ANO_FIM_PONTO = "1985-01-01", "2024-12-31"  # 40 anos


ponto_goiania = (
    ds_era5_horario["t2m"]
    .sel(valid_time=slice(ANO_INICIO_PONTO, ANO_FIM_PONTO))
    .sel(
        latitude=lat_goiania,
        longitude=ajusta_lon_h(lon_goiania),
        method="nearest",
    )
)
ponto_goiania
<xarray.DataArray 't2m' (valid_time: 350640)> Size: 1MB
dask.array<getitem, shape=(350640,), dtype=float32, chunksize=(1440,), chunktype=numpy.ndarray>
Coordinates:
* valid_time (valid_time) datetime64[ns] 3MB 1985-01-01 ... 2024-12-31T23:...
latitude float64 8B -16.6
longitude float64 8B 310.7
Attributes: (12/32)
GRIB_paramId: 167
GRIB_dataType: fc
GRIB_numberOfPoints: 5299200
GRIB_typeOfLevel: surface
GRIB_stepUnits: 1
GRIB_stepType: instant
... ...
GRIB_totalNumber: 0
GRIB_units: K
long_name: 2 metre temperature
units: K
standard_name: unknown
last_ingested_valid_time_index: 672047%%time
ponto_goiania = ponto_goiania.load()
temperatura_celsius = ponto_goiania - 273.15
temperatura_celsius.attrs = {"units": "degC", "long_name": "Temperatura do ar a 2m em Goiânia"}
temperatura_celsiusCPU times: user 20.9 s, sys: 2.94 s, total: 23.8 s
Wall time: 6min 13s<xarray.DataArray 't2m' (valid_time: 350640)> Size: 1MB
array([21.350006, 20.850006, 20.850006, ..., 23.350006, 22.975006,
       22.131256], shape=(350640,), dtype=float32)
Coordinates:
* valid_time (valid_time) datetime64[ns] 3MB 1985-01-01 ... 2024-12-31T23:...
latitude float64 8B -16.6
longitude float64 8B 310.7
Attributes:
units: degC
long_name: Temperatura do ar a 2m em GoiâniaExiste até um índice climático parecido com esse já batizado na literatura: noites tropicais (tropical nights), normalmente definidas como dias em que a temperatura mínima não cai abaixo de 20°C. Aqui usamos um limiar mais rígido, 24°C, pra marcar as noites de calor realmente extremo.
resample pra 1 valor de mínima por dia
minima_diaria = temperatura_celsius.resample(valid_time="1D").min()

LIMITE_NOITE_QUENTE = 24.0  # °C
noite_quente = minima_diaria > LIMITE_NOITE_QUENTE

noites_quentes_por_ano = noite_quente.groupby("valid_time.year").sum()
noites_quentes_por_ano
<xarray.DataArray 't2m' (year: 40)> Size: 320B
array([0, 0, 0, 0, 0, 0, 0, 0, 0, 2, 0, 0, 2, 0, 0, 0, 0, 2, 0, 1, 0, 0,
       4, 2, 0, 1, 0, 2, 0, 1, 2, 1, 3, 0, 5, 3, 2, 1, 6, 8])
Coordinates:
* year (year) int64 320B 1985 1986 1987 1988 ... 2021 2022 2023 2024
latitude float64 8B -16.6
longitude float64 8B 310.7
Attributes:
units: degC
long_name: Temperatura do ar a 2m em Goiânianoites_quentes_por_ano.hvplot.bar(
x="year", color="firebrick", height=350, width=850,
title=f"Noites com mínima acima de {LIMITE_NOITE_QUENTE:.0f}°C, por ano em Goiânia",
xlabel="Ano",
ylabel="Nº de noites",
)